
#AutoTranslate
Descrizione breve
«Stazioni dei taxi Svizzera» è un nuovo record di dati in formato GeoJSON con stazioni dei taxi in Svizzera. Il record viene generato sulla base di diverse fonti open data, tra cui OpenStreetMap e esportazioni di geodati da diverse città e Cantoni.
Ultime notizie
2026-10-13 Pubblicazione della versione corretta del record di dati con 288 stazioni di taxi, mantenuta come «Alpha».
2026-10-06 prima versione del record pubblicata come «Alpha».
Accesso ai dati:
Include l’anteprima dei dati in una visualizzazione della mappa.
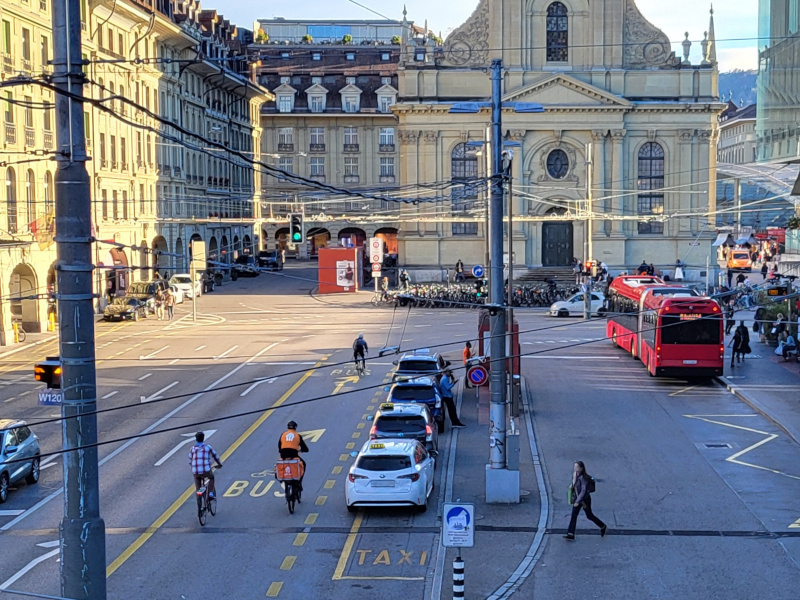
Fermata dei taxi alla stazione di Berna, Svizzera. Fonte: Team opentransportdata.swiss.
Descrizione del funzionamento
Disclaimer – Nota bene:
- Questo record è «Alfa« quindi un prototipo. I contenuti, i formati, la messa a disposizione e l’aggiornamento possono essere modificati o interrotti in qualsiasi momento senza preavviso.
- Non è garantito che la fermata dei taxi sia servita in un determinato orario o che i taxi siano disponibili sul posto.
- I dati sono forniti senza garanzia. I dati possono contenere errori.
Piazzole di sosta dei taxi in Svizzera
In Svizzera le piazzole di sosta per taxi vengono definite, introdotte e gestite in base a diverse basi legali (leggi e ordinanze cantonali o comunali). Di norma, i fornitori di servizi taxi autorizzati a livello locale o regionale possono attendere i clienti con i loro taxi.
Possibili casi applicativi
Per quanto riguarda la mobilità, i dati delle fermate dei taxi sono interessanti nei seguenti casi applicativi:
- POI: fermate dei taxi come punti di interesse per la visualizzazione nelle app di mobilità
- Pianificazione del viaggio: Gli organizzatori del viaggio possono calcolare una catena di viaggio che prevede come ultima parte di viaggio una corsa dalla fermata dei taxi.
Cosa contiene il record?
I dati indicano sostanzialmente le posizioni e la capacità (numero di posti) delle fermate dei taxi. I dati forniscono le seguenti informazioni per ogni fermata di taxi:
- Ubicazione (coordinate WGS 84, longitude/latitude)
- Capacità: il numero di posti.
- Nome o descrizione (in parte con indirizzo, numero civico ecc.)
- eventuali osservazioni.
.
Descrizione tecnica
Formato e struttura dei record
I file sono nel formato GeoJSON, quindi come file JSON e codificati in UTF-8. La base è lo standard GeoJSON (vedi https://de.wikipedia.org/wiki/GeoJSON). La struttura dei dati è una GeoJSON «FeatureCollection» che contiene un elenco (array [ ]) con «Feature». Ogni fermata dei taxi corrisponde a una Feature.
Secondo lo standard GeoJSON, una feature contiene le seguenti chiavi:
- “id”: un ID tecnico.
- “geometry”: come geometria utilizziamo esclusivamente punti, quindi «type»: «Point» e «coordinates» (coordinate) mt in un array con le due coordinate WGS 84 longitude, latitude (longitudine, latitudine).
- “properties”: tutte le altre caratteristiche come coppie chiave-valore.
Tra le Property vale la pena notare (tutte opzionali):
- «#id»: Identificatore che identifica in modo univoco una fermata dei taxi all’interno di questo record di dati. Nota bene: L’ID di una fermata dei taxi può cambiare a qualsiasi versione, quindi non è garantito per le versioni future.
- «source»: indica la fonte di questa voce.
- «last_update»: la data dell’ultimo aggiornamento, in genere la data dell’ultima esportazione dalla sorgente data.
- «name»: nome o denominazione di una località, a volte anche con indirizzo, numero civico, numero postale d’avviamento e/o località. Il nome è utile a fini di visualizzazione (interfaccia utente), ma non è univoco e univoco.
- «capacity»: il numero di posti (parcheggi) per i taxi disponibili in questa località.
- «notes» (note): eventuali ulteriori informazioni, note e osservazioni.
- altre Property con prefisso «__»: Si tratta dei campi dati originali o delle chiavi della rispettiva fonte.
Generazione del record di dati
La generazione del record avviene tramite script. Le fonti vengono importate e i campi di dati necessari vengono ricavati da esse. In una fase di consolidamento vengono inoltre individuati ed eliminati gli inserimenti doppi, eliminando di volta in volta i dati provenienti da un’unica fonte.